O seu conhecimento. A sua infraestrutura. IA à medida da organização.
Ligamos a sua informação, adaptamos modelos open-source e construímos as aplicações e a infraestrutura GPU que os tornam úteis. Da primeira fonte de dados à operação diária, desenhamos a solução para os seus processos, pessoas e requisitos de confidencialidade.
- Dados e inferência sob o seu controlo
- Modelos adaptados ao seu trabalho
- Dos servidores GPU às aplicações
Cada camada tem uma função. E uma equipa que a implementa.
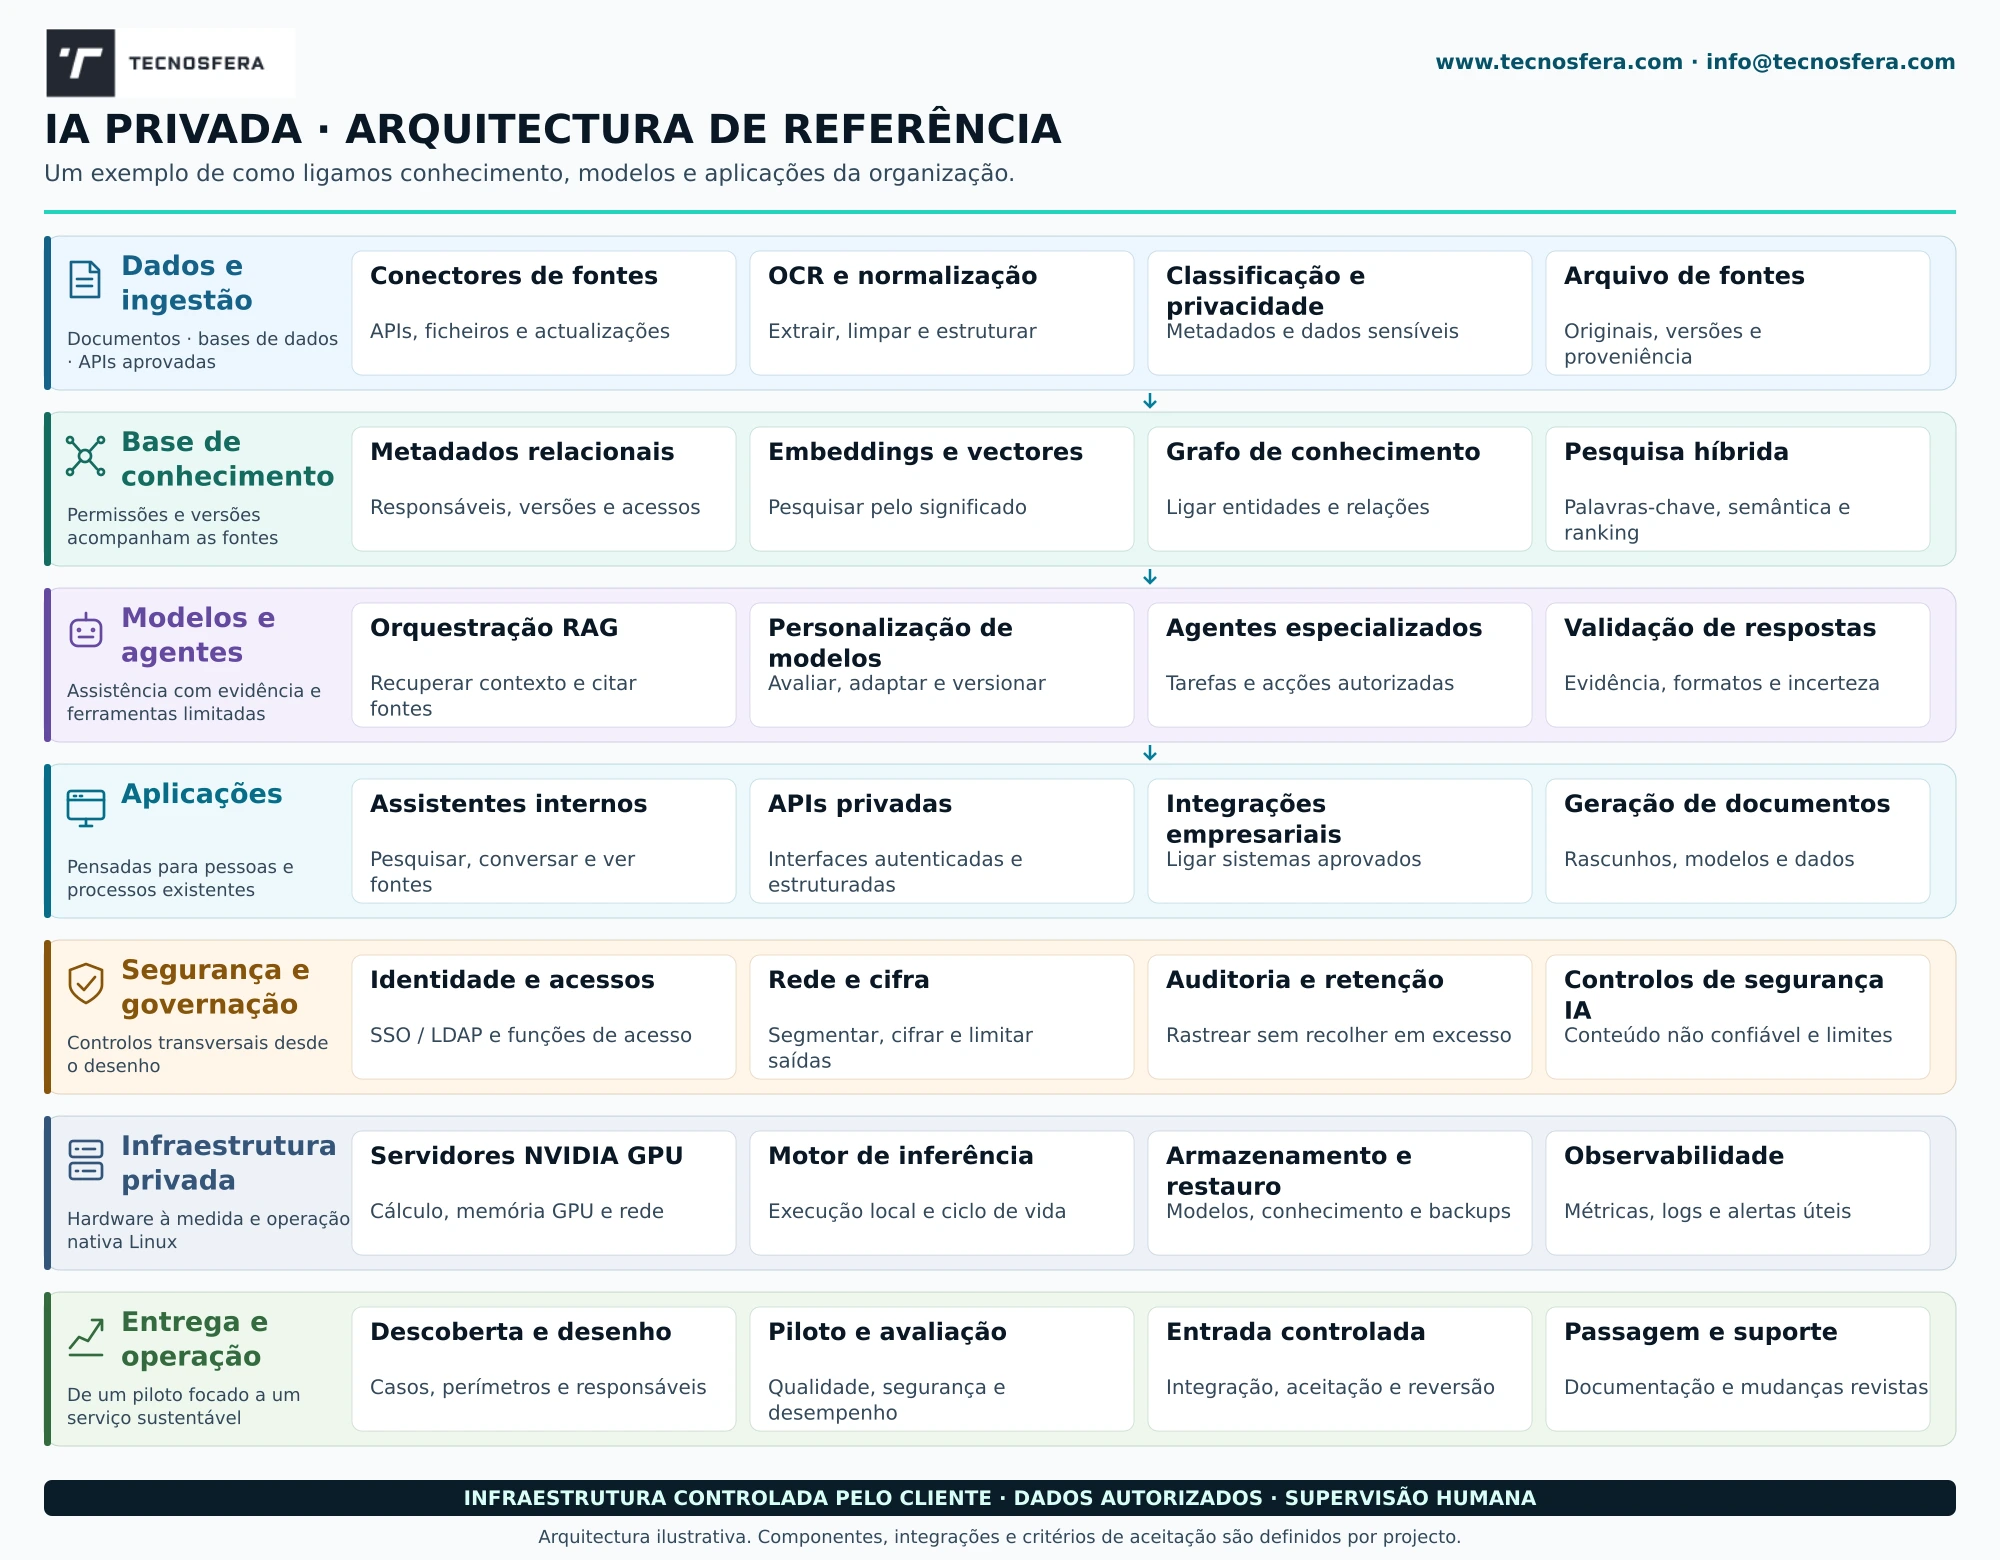
Um exemplo de arquitectura de IA interna, independente do sector. Explore os componentes para perceber o que fazem, o que a Tecnosfera implementa e como se verifica o resultado.
Dados e ingestão
Ligar e preparar a informação que importa.
Documentos, bases de dados e aplicações empresariais guardam conhecimento em formatos diferentes. Construímos processos de ingestão através de APIs autorizadas, transferência de ficheiros e repositórios, com actualizações agendadas ou incrementais conforme a fonte.
A preparação pode incluir OCR para documentos digitalizados, limpeza, deduplicação, classificação e extracção de metadados. Campos sensíveis podem ser detectados e ocultados ou pseudonimizados segundo regras acordadas; o processamento automático exige validação com dados representativos.
- Origem, versão e histórico de actualização associados ao conteúdo
- Verificação de qualidade e tratamento de importações rejeitadas ou incompletas
- Regras de retenção, acesso e eliminação definidas com os responsáveis pela informação
Explore cada componente: função, implementação e validação.
Conectores de fontes
- O que faz
- Trazer dados autorizados de repositórios, bases de dados e sistemas para um processo controlado.
- O que implementamos
- Mapeamento de fontes, credenciais com acesso mínimo, importações agendadas ou incrementais, retries e registo de origem.
- Como validamos
- Reconciliação com a fonte e testes de duplicados, falhas de ligação e alterações de permissões.
OCR e normalização
- O que faz
- Tornar documentos digitais e digitalizados utilizáveis pela pesquisa e pelo processamento seguinte.
- O que implementamos
- Extracção de texto, OCR, conversão de formatos, deduplicação e segmentação com referências às páginas.
- Como validamos
- Verificação de digitalizações, tabelas e ficheiros malformados; conteúdo ilegível encaminhado para revisão.
Classificação e privacidade
- O que faz
- Organizar conteúdo e limitar a exposição de informação sensível antes da indexação.
- O que implementamos
- Classificação documental, extracção de entidades e regras acordadas de ocultação ou pseudonimização.
- Como validamos
- Medição de omissões e detecções incorrectas em exemplos classificados. A ocultação automática não é considerada infalível.
Arquivo de fontes
- O que faz
- Manter uma referência controlada ao material usado para construir o conhecimento pesquisável.
- O que implementamos
- Armazenamento versionado, checksums, proveniência e retenção; armazenamento imutável quando necessário.
- Como validamos
- Recuperação do original e testes de acesso, retenção e eliminação, incluindo a remoção dos índices.
Base de conhecimento
Transformar conteúdo disperso em conhecimento pesquisável.
Combinamos pesquisa por palavras-chave e pesquisa semântica para encontrar informação relevante para além de uma expressão exacta. Conforme o caso de uso, a base de conhecimento pode incluir índices vectoriais, metadados relacionais e um grafo que liga entidades e conceitos.
A geração aumentada por recuperação (RAG) fornece ao modelo informação relevante e autorizada no momento de responder. Desenhamos a pesquisa em função dos acessos do utilizador, das versões das fontes e de referências úteis, para permitir consultar a evidência por trás da resposta.
- Pesquisa em fontes internas autorizadas
- Filtros por tema, tipo de documento, versão e permissões de acesso
- Actualização e remoção do conteúdo indexado quando a fonte muda
Explore cada componente: função, implementação e validação.
Metadados relacionais
- O que faz
- Registar responsáveis, ciclo de vida, classificação e permissões separadamente do texto gerado.
- O que implementamos
- Modelos de metadados, controlo de versões e propagação de actualizações e eliminações entre repositórios.
- Como validamos
- Verificação de que mudanças na fonte e nos acessos se reflectem nas pesquisas seguintes.
Embeddings e vectores
- O que faz
- Representar passagens dos documentos para pesquisa por semelhança semântica.
- O que implementamos
- Avaliação do modelo de embeddings, estratégia de segmentação, indexação vectorial e reindexação controlada.
- Como validamos
- Testes de relevância nas línguas e terminologia da organização, incluindo perguntas ambíguas ou sem relação.
Grafo de conhecimento
- O que faz
- Representar relações entre entidades, conceitos e documentos quando o caso de uso beneficia dessa estrutura.
- O que implementamos
- Modelo de entidades, extracção de relações, ligações às fontes e consultas ao grafo. Esta camada é opcional.
- Como validamos
- Revisão das relações face às fontes e testes de correcção, eliminação e evidência contraditória.
Pesquisa híbrida
- O que faz
- Combinar correspondências precisas com pesquisa semântica para seleccionar evidência útil.
- O que implementamos
- Índices textuais, pesquisa vectorial, ranking, filtros de metadados e controlo de acesso na recuperação.
- Como validamos
- Medição de relevância e latência; testes para impedir resultados com material restrito.
Modelos e agentes
Adaptar modelos e agentes à tarefa real.
Avaliamos modelos com a linguagem, terminologia, tarefas e hardware da organização. Começamos por prompts, pesquisa de contexto e ferramentas controladas; o fine-tuning é considerado quando os testes demonstram essa necessidade e os dados disponíveis e a licença do modelo o permitem.
Agentes especializados podem apoiar extracção, classificação, comparação, resumo e redacção. Definimos as ferramentas permitidas, as acções que exigem aprovação humana e quando o agente deve parar. A verificação de fontes e um modelo adicional de revisão podem ajudar a identificar respostas sem suporte, mas não garantem que estejam correctas.
- Conjuntos de teste representativos e critérios de aceitação acordados
- Versões de modelos, prompts e configurações de conhecimento
- Incerteza, falta de evidência e necessidade de revisão visíveis
Explore cada componente: função, implementação e validação.
Orquestração RAG
- O que faz
- Reunir evidência permitida e instruções para cada pedido ao modelo.
- O que implementamos
- Orquestração da pesquisa, limites de contexto, referências, versões documentais e respostas por falta de evidência.
- Como validamos
- Verificação do suporte das respostas e das citações, incluindo fontes ausentes, desactualizadas ou contraditórias.
Personalização de modelos
- O que faz
- Adequar o comportamento do modelo às tarefas, linguagem e hardware da organização.
- O que implementamos
- Selecção de modelos, prompts e parâmetros de inferência; fine-tuning apenas com dados autorizados e benefício demonstrado.
- Como validamos
- Comparação de configurações com exemplos acordados, critérios de qualidade, recursos e condições de licença.
Agentes especializados
- O que faz
- Dividir um processo em tarefas explícitas de extracção, comparação, classificação ou redacção.
- O que implementamos
- Encaminhamento de tarefas, ferramentas restritas, limites de execução, tratamento de erros e aprovação humana.
- Como validamos
- Testes de timeout, resultados inesperados, acções repetidas e tentativas de ultrapassar permissões.
Validação de respostas
- O que faz
- Ajudar a detectar afirmações sem suporte, formatos inválidos e respostas inconsistentes.
- O que implementamos
- Validação de esquemas e referências, revisão opcional por outro modelo e encaminhamento para uma pessoa.
- Como validamos
- Casos de falha conhecidos para medir os erros que persistem. Um segundo modelo não garante a verdade.
Aplicações
Levar a IA às ferramentas que as equipas utilizam.
Desenvolvemos aplicações web, assistentes internos e APIs em torno dos processos da organização. A integração pode ligar sistemas empresariais e repositórios aprovados, sem obrigar as equipas a transferir o trabalho para um chatbot público.
As aplicações possíveis incluem um assistente de conhecimento interno, comparação de documentos, extracção estruturada de informação, apoio a equipas operacionais e preparação de relatórios ou primeiras versões de textos. Cada aplicação tem as suas permissões, processo de revisão e âmbito de integração.
- Interfaces de conversação com referências às fontes
- Resultados estruturados e processos de geração de documentos
- Aprovação explícita antes de alterações com impacto nos sistemas ligados
Explore cada componente: função, implementação e validação.
Assistentes internos
- O que faz
- Dar às equipas autorizadas uma interface útil para consultar conhecimento interno.
- O que implementamos
- Interfaces web, fluxos de conversação, consulta de fontes, feedback e indicação das limitações.
- Como validamos
- Aceitação pelos utilizadores, acessibilidade por teclado e troca de conta sem exposição de dados entre pessoas.
APIs privadas
- O que faz
- Disponibilizar funções de IA seleccionadas a aplicações aprovadas.
- O que implementamos
- Contratos versionados, autenticação, validação de pedidos, limites e identificadores de correlação.
- Como validamos
- Testes de contrato, autorização e carga; tratamento previsível de pedidos inválidos e dependências indisponíveis.
Integrações empresariais
- O que faz
- Inserir a assistência de IA nos fluxos de informação e operação existentes.
- O que implementamos
- Adapters por projecto, mapeamento de campos, acessos limitados de leitura/escrita e confirmação de alterações.
- Como validamos
- Testes de contrato, falhas parciais, retries e limites de aprovação com o responsável do sistema.
Geração de documentos
- O que faz
- Transformar informação autorizada em rascunhos e resultados estruturados.
- O que implementamos
- Templates, extracção de campos, formatação, referências às fontes e revisão humana antes da utilização final.
- Como validamos
- Verificação de campos obrigatórios, formato, exactidão das fontes e informação em falta.
Segurança e governação
Incorporar confidencialidade e governação em todas as camadas.
O alojamento privado é um ponto de partida, não uma garantia de segurança. Desenhamos integração de identidade, acesso por funções, cifra, segmentação de rede e auditoria de acordo com as políticas da organização. As restrições de acesso também se aplicam ao conteúdo recuperado e às ferramentas dos agentes.
Documentos e respostas do modelo são tratados como entradas não confiáveis. Permissões limitadas, validação de resultados e limites de aprovação ajudam a conter riscos de injecção de instruções. Logs, backups e acessos de suporte fazem parte do perímetro dos dados desde o desenho da solução.
- Integração com autenticação empresarial, incluindo SSO ou LDAP quando necessário
- Ligações de saída controladas e segredos fora dos prompts
- Políticas de retenção e auditoria acordadas com os responsáveis de segurança e privacidade
Explore cada componente: função, implementação e validação.
Identidade e acessos
- O que faz
- Aplicar as políticas de identidade e autorização da organização ao serviço de IA.
- O que implementamos
- Integração de identidade, funções, separação administrativa e verificação de permissões na pesquisa e nas ferramentas.
- Como validamos
- Testes de acesso negado, mudança de função e revogação, incluindo caches e conversas anteriores.
Rede e cifra
- O que faz
- Definir por onde circula a informação e como é protegida.
- O que implementamos
- Perímetros de rede, TLS, cifra de armazenamento, gestão de segredos e ligações de saída autorizadas.
- Como validamos
- Revisão de certificados, caminhos de acesso, exposição de segredos e comunicações de saída inesperadas.
Auditoria e retenção
- O que faz
- Apoiar investigação e controlo do ciclo de vida sem registar indiscriminadamente conteúdo sensível.
- O que implementamos
- Eventos de auditoria, referências às versões, minimização de logs, retenção e procedimentos de eliminação.
- Como validamos
- Rastreio de pedidos e testes de acesso, retenção e eliminação nos logs e repositórios.
Controlos de segurança IA
- O que faz
- Limitar o impacto de instruções maliciosas em documentos e de resultados inseguros do modelo.
- O que implementamos
- Separação entre instruções e fontes, ferramentas restritas, validação de resultados e aprovação humana.
- Como validamos
- Testes adversariais de injecção de instruções, divulgação de dados e uso indevido de ferramentas; riscos residuais documentados.
Infraestrutura privada
Servidores NVIDIA GPU à medida. IA operada localmente.
Desenhamos, montamos e configuramos servidores com GPUs NVIDIA, seleccionando capacidade de cálculo, memória GPU, RAM, armazenamento e rede para os modelos e a carga prevista. Dimensionamos o hardware em conjunto com o motor de inferência.
Modelos, bases de conhecimento, inferência e logs operacionais podem funcionar integralmente em infraestrutura local controlada pelo cliente, sem uma API pública de IA durante a execução. Suportamos instalações nativas Linux sem exigir Kubernetes. Monitorização, backups e procedimentos de restauro fazem parte do desenho operacional acordado.
- Dimensionamento e testes para a utilização simultânea prevista
- Monitorização de latência, erros, filas, utilização GPU e armazenamento
- Actualizações controladas de modelos, reversão e testes de recuperação
Explore cada componente: função, implementação e validação.
Servidores NVIDIA GPU
- O que faz
- Disponibilizar capacidade local para os modelos seleccionados e a utilização prevista.
- O que implementamos
- Desenho, montagem e configuração de servidores: memória GPU, RAM, CPU, armazenamento, rede e requisitos térmicos.
- Como validamos
- Testes com cargas representativas, concorrência, margem de memória e estabilidade do hardware.
Motor de inferência
- O que faz
- Carregar e disponibilizar modelos aprovados com controlo dos recursos.
- O que implementamos
- Serviços nativos Linux, execução de modelos, filas, limites e configuração versionada. Não exige Kubernetes.
- Como validamos
- Medição de tempos de resposta e testes de sobrecarga, reinício, actualização controlada e reversão.
Armazenamento e restauro
- O que faz
- Proteger os dados operacionais e exercitar a recuperação.
- O que implementamos
- Dimensionamento, políticas de backup, cópias protegidas e procedimentos de restauro dos componentes acordados.
- Como validamos
- Restauro de backups e verificação de consistência. Os objectivos de recuperação são definidos por projecto.
Observabilidade
- O que faz
- Tornar visíveis desempenho, falhas e pressão sobre recursos.
- O que implementamos
- Dashboards de disponibilidade, latência, erros, filas, GPU, CPU, memória, disco e rede; logs limitados e encaminhamento de alertas.
- Como validamos
- Simulação de falhas, recepção de alertas e confirmação de que os logs não expõem dados sensíveis desnecessários.
Entrega e operação
Um percurso prático da descoberta à operação.
Começamos com um problema definido, informação autorizada e critérios de aceitação mensuráveis. Um piloto focado permite validar modelos, pesquisa e hardware antes de integrar a aplicação em processos mais abrangentes.
A entrega acordada pode incluir conectores de dados, base de conhecimento, configuração de modelos, interfaces, infraestrutura e documentação operacional. Os componentes e o âmbito do serviço são seleccionados por projecto; não se trata de uma stack fixa nem de impor todas as camadas em cada instalação.
- Descobrir: mapear casos de uso, dados, utilizadores e confidencialidade
- Validar: testar qualidade, acessos e desempenho com exemplos autorizados
- Integrar: ligar a aplicação e fazer uma entrada controlada em operação
- Operar: monitorizar, apoiar e avaliar alterações face à referência acordada
Explore cada componente: função, implementação e validação.
Descoberta e desenho
- O que faz
- Acordar o que o sistema deve fazer e a informação que pode utilizar.
- O que implementamos
- Mapeamento de casos, inventário de dados, arquitectura, responsabilidades e critérios de aceitação mensuráveis.
- Como validamos
- Revisão de pressupostos e âmbito com negócio, responsáveis pela informação, segurança e operações.
Piloto e avaliação
- O que faz
- Reunir evidência antes de alargar a instalação.
- O que implementamos
- Piloto focado, exemplos de avaliação autorizados e testes comparativos de modelos, pesquisa e hardware.
- Como validamos
- Revisão face à referência acordada e documentação das limitações e riscos por resolver.
Entrada controlada
- O que faz
- Introduzir a solução nos processos aprovados em incrementos controláveis.
- O que implementamos
- Configuração de ambientes, testes de integração, acesso faseado, verificações operacionais e plano de reversão.
- Como validamos
- Aceitação pelos utilizadores designados e ensaio de recuperação antes de alargar acessos.
Passagem e suporte
- O que faz
- Manter a solução compreensível e sustentável após a entrega inicial.
- O que implementamos
- Documentação operacional, passagem às equipas, monitorização e âmbito de suporte e actualizações acordado.
- Como validamos
- Repetição dos testes relevantes quando modelos, fontes de dados ou infraestrutura mudam.
O essencial, sem ambiguidade.
A solução pode funcionar integralmente na nossa infraestrutura?
Sim. Modelos, bases de conhecimento, inferência e logs podem ficar localmente, sem chamar uma API pública de IA durante a execução. Downloads, actualizações, telemetria, backups e acesso de suporte também têm de ser revistos para estabelecer o perímetro de rede pretendido.
Os nossos documentos têm de treinar o modelo?
Não. O RAG recupera informação relevante para um pedido sem alterar os pesos do modelo. O fine-tuning é uma decisão separada, com dados autorizados, finalidade definida e avaliação própria.
Um modelo privado elimina respostas incorrectas?
Não. O alojamento local não elimina erros do modelo. Pesquisa, referências, testes, recusa de respostas sem suporte e revisão humana ajudam a gerir o risco; uma resposta com citação continua a precisar de verificação face à fonte.
Este serviço está limitado a um sector?
Não. Adaptamos a arquitectura à informação e aos processos de cada organização. O caso de uso, os acessos às fontes e os critérios de aceitação determinam a implementação, não uma aplicação sectorial pré-definida.
Precisamos de todos os componentes ou de Kubernetes?
Não. Seleccionamos a arquitectura mais simples que cumpre os requisitos acordados. Suportamos operação nativa em Linux; um grafo de conhecimento, agentes adicionais ou fine-tuning só são incluídos quando se justificam.
Como são escolhidos os modelos e componentes open-source?
Avaliamos qualidade na tarefa, linguagem, requisitos de hardware, manutenção e condições de licença. A disponibilização dos pesos de um modelo não significa, por si só, utilização sem restrições; verificamos a licença para a instalação pretendida.
Comece pelo trabalho que pretende melhorar com IA.
Partilhe o caso de uso, as fontes de informação e os requisitos de confidencialidade. Definimos aplicação, modelos e infraestrutura em conjunto. Não inclua documentos confidenciais no primeiro email.